
AI 是怎样 “学习”的?一文揭开神经网络模仿人脑的秘密
神经网络的构想,最早受人类大脑工作机制的启发。人类大脑是一个庞大的网络系统,包含约860亿个神经元,以及100万亿到1000万亿个神经连接(突触),网络中的电信号与化学信号的传递,正是人类产生意识,实现学习与思考的生理基础。
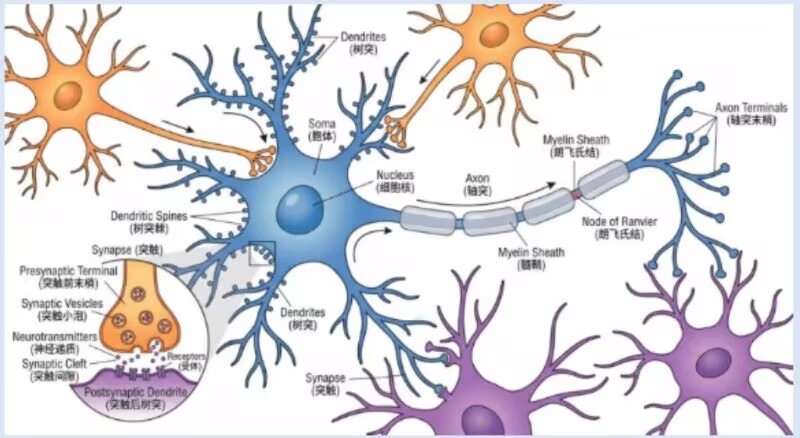
机器学习中的神经网络简直就是人类大脑的简化模型!
基础神经元模型主要由三部分构成:
1、能够汇总处理输入信号、按照特定逻辑输出结果的节点
2、若干信号输入端口
3、信号输出端口
具体来讲,神经元同时接收来自n个前序神经元的输出信号X1,X2....Xn,这些信号用不同大小的数值来表示,它对应了人类神经元的树突部分接收其他神经元通过轴突所释放的化学信号,继而转换为电信号;这些输入信号经过人类神经元的胞体(计算节点)的处理,形成传递到后续神经元的信号。
机器学习在节点上定义了许多数学模型,它们通常是将输入信号X乘以对应的一个权重W后得出一个值,同时通过一个偏置变量b来调节该值,最后获得一个输出信号,然后再通过一个“激活函数”,比如sigmoid或者ReLU形成一个最终的输出信号,这个信号就是下一个神经元的输入信号X。
那么机器学习过程究竟是在训练哪些参数呢?
答案是每个神经元的所有权重值W以及偏置b,这些参数就是机器学习的结果。我们通常所说的模型尺寸就是指整个网络中权重和偏置的个数总和。举个例子,比如GPT3的尺寸是175B,层数是96层,每一层的宽度是12,288(也就是每层节点的个数)。本质上,w和b代表了海量样本的统计规律,是被压缩和固化下来的一组高维数学参数。百亿、千亿的w和b协同工作在整体上产生了高级智力和推理能力,这种现象叫作“涌现”。
那么有人会问了,神经网络的层数、宽度、连接方式这些不训练吗?
答案是在通常情况下,这些是人类工程师在训练之前就设定好的“超参数”,它们在训练过程中是不允许被改变的。
下面我们通过一个简单的例子来了解神经网络的学习过程,看看机器训练究竟是怎么一回事。
假设我们做一道西红柿炒蛋,用X1代表放盐量、X2代表放糖量,Y代表好吃程度,其他因素每次做这道菜的时候保持不变。我们做了很多次这道菜并记录了放盐量和放糖量以及家人对好吃程度的打分,形成了许多份样本如下:
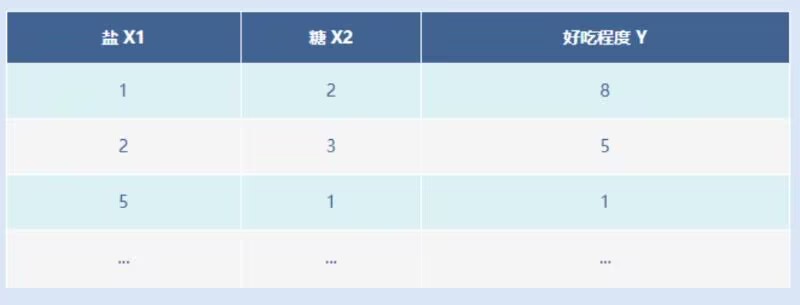
我们预设了一个神经网络,包含一个输入层,一个输出层以及一个隐藏层(宽度为2),输出层没有激活函数,偏置为1,隐藏层的激活函数选择ReLU(当前最流行的一种激活函数,即大于等于0的输出原样放行,小于0的输出恒为0),所有权重值在预设范围内随机初始化,隐藏层偏置均初始为0,误差函数设置为:
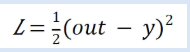
神经网络如下:
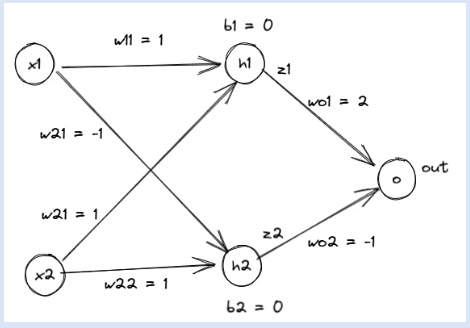
首先我们输入第一个样本X1=1,X2=2,y=8,那么我们计算一下out值:
Z1=ReLU(x1×w11+x2×w21+b1)=ReLU(1×1+2×1+0)=3
Z2=ReLU(x1×w21+x2×w22+b2)=ReLU(1×-1+2×1+0)=1
Out=w01×z1+w02×z2+b0=2×3+(-1)×1+1=5
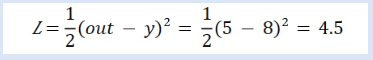
我们发现实际样本的y为8,当前模型预测的输出out为5,这说明我们的模型还存在误差,所以需要根据该误差的大小,调整所有的权重w和偏置b以使得该误差能够变小,使模型在这一个样本上能够更加贴近实际,即让模型通过这个样本进行学习。通过上面的计算过程我们得知,在该样本中,L可以表示为所有w和b的函数,其他值如X均为常数,即
L=f(w,b)
我们可以想象一个纵坐标为L,横坐标为所有w和b(包括w11,w12,w21,w22,b0,b1,b2)组成的高维曲线,w和b的当前值为我们关注的位置,也叫工作点。我们可以这样想,如果某个w或者某个b在关注点上“稍微”变大或者变小一点,那么工作点上的误差(L)也许可以降低一点。因此我们让这个w或者b相应调整一下,这个模型不就变得更好了嘛。
接下来我们让L对每个w和每个b分别求偏微分,即求L在关注点位置上对某个w或者b求导数(假设其他w和b保持不变)。如果导数是正的,意味着这个w或者b减少一点,L会变小;如果这个导数是负的,意味着这个w或者b增加一点,L会变小。这样我们就知道了是增大该参数还是减小该参数,同时导数越大意味着调整该参数会效果明显,反之效果则越不明显,导数如果为0,那么这个参数无论在该关注点上怎么变都没用,所以无需调整。
举个例子,依据上述公式和求导链式法则,我们看看L对W11的偏微分应该怎么求:
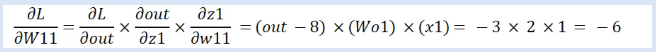
由此,我们知道将w11增大一点,对L的降低有好处,因为L的影响因素除了W11还有其他权重和偏置,在一次训练中我们要同时更新所有的w和b,所以我们对w11的调整要非常克制。因此,更新w11为:
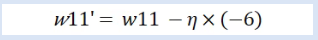
其中-6即为偏导数,η为学习效率,通俗地讲,就是改进的程度,它是一个经验常数,该值过大可能过度调整错过最优值,该值过小则训练的速度会变慢,因此该值的大小是非常关键的经验参数。以上这个参数优化的方法就叫做“梯度法”。
由此,我们知道了w11的调整方式,其他w和b方法和过程完全相同。
在对每个的w和b进行一次训练后,会统一更新模型的w和b。接着把第二个样本输入,重复上述过程,持续不断地使用样本训练w和b。
实际上,当我们确定了w和b之后,可以把所有的x当成变量,w和b当作常数,误差L作为函数值,得到了误差与输入变量之间的关系函数,我们希望训练后的这个函数无论输入变量怎么变,L的值都是比较小,且比较稳定(不震荡)。有时候我们训练过头了,则这个函数为了强行拉低个别特殊点的误差而生成“扭曲、变态”的参数,因此丧失泛化能力(一般性),也就是对未知的输入预测明显偏差,我们称这种现象为“过拟合”。
回到我们的例子,在我们用样本把模型训练完毕以后,我们就能够预测一下在这个家庭当中,西红柿炒蛋这道菜放入多少盐,多少糖,好吃的程度是多少了,继而掌握了做这道菜的经验和结论,这也就是机器学习带来的好处。
以上就是神经网络的一个基本原理的简介
- 上一篇:没有啦
- 下一篇:TVS为什么离接口越远,保护越差? 2026/10/27

